로컬 AI 모델에게 "한 문장으로 자기소개 해줘"라고 했더니 답이 오기까지 2~3분이 걸렸습니다. 그래픽카드가 약해서가 아니었습니다. 제 PC(AMD 라데온 RX 6800 XT)에서는 원인이 두 가지 겹쳐 있었습니다. 에이전트 앱이 메시지마다 약 2만 토큰짜리 입력을 보내고 있었고, Ollama가 AMD 전용 가속(ROCm) 대신 범용 방식(Vulkan)으로 몰래 돌고 있었습니다. 두 번째를 고치자 2만 5천 토큰 입력 처리가 약 9분에서 약 30초로 줄었습니다.
아래 수치는 모두 2026년 9월 28일 Windows 11 PC 한 대에서 Ollama 0.34.4와 qwen3 8b·14b(Q4_K_M)로 직접 잰 값입니다. PC마다 숫자는 다르겠지만 점검 순서는 그대로 쓸 수 있습니다.
증상: 인사 한마디에 3분
- 로컬 Ollama에 연결한 데스크톱 AI 에이전트 앱이 인사 한 줄에 "Worked for 2m 53s"를 표시했습니다.
- 같은 앱에서 유료 클라우드 모델을 고르면 몇 초 만에 답했습니다. 그래서 앱 문제는 아닌 것처럼 보였습니다.
- 터미널에서
ollama run으로 짧게 물어보면 빨랐습니다. 그래서 느린 게 들쭉날쭉해 보였습니다.
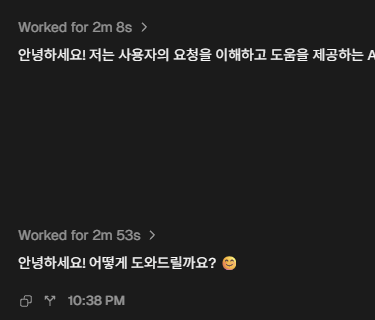
수정 전: 인사 한 줄에 2분 8초, 2분 53초가 걸렸습니다.
1단계: "읽는 시간"과 "쓰는 시간"을 나눠 보기
AI 응답 시간은 크게 두 부분입니다. 입력을 읽는 시간(프롬프트 처리)과 답을 만들어 내는 시간(생성)입니다. Ollama는 요청마다 이 두 시간을 따로 알려 줍니다.
curl -s localhost:11434/api/chat -d '{"model":"qwen3:8b","stream":false,
  "messages":[{"role":"user","content":"hi"}]}'
# 입력 처리 속도 = prompt_eval_count / (prompt_eval_duration / 1e9)
# 생성 속도     = eval_count / (eval_duration / 1e9)
Windows에서는 %LOCALAPPDATA%\Ollama\server.log에도 같은 수치가 요청마다 남습니다. 입력 크기는 task.n_tokens로 나옵니다. 로그를 보니 원인이 바로 드러났습니다.
| 항목 | 측정값 | 판단 |
|---|---|---|
| 답변 생성 속도 | 초당 50~67토큰 | 정상 |
| 앱이 보내는 입력 크기 | 메시지당 14,000~19,500토큰 | 시스템 지시문·도구 정의·대화 기록 |
| 입력 처리 속도 | 초당 약 21토큰 | 비정상. 여기가 병목 |
답을 쓰는 속도는 멀쩡했고, 입력을 읽는 속도만 비정상이었습니다. 클라우드 API는 2만 토큰을 1~2초면 읽기 때문에 같은 앱에서도 티가 나지 않았던 겁니다.
함정이 하나 더 있습니다. Ollama는 기본 설정(OLLAMA_NUM_PARALLEL=1)에서 요청을 한 번에 하나씩 처리합니다. 계산 자체는 0.2초면 끝나는 짧은 테스트 요청도, 앱의 2만 토큰 요청 뒤에 줄을 서느라 60초 뒤에 돌아왔습니다. 앱을 켜 둔 채로 속도를 재면 대기 줄의 길이를 재게 됩니다.
2단계: Ollama가 실제로 어떤 가속 방식을 쓰는지 확인
서버 로그에서 inference compute를 검색합니다.
msg="inference compute" library=Vulkan ... description="AMD Radeon RX 6800 XT"library=Vulkan이면 AMD 전용 ROCm이 아니라 범용 Vulkan으로 돌고 있다는 뜻입니다. RX 6800 XT(gfx1030)는 Ollama GPU 문서에 ROCm 지원 카드로 올라 있습니다. 그러니 Vulkan은 의도한 설정이 아니라 ROCm이 안 잡혀서 떨어진 결과입니다.
쉬운 방법부터 해 봤습니다. 제 PC에는 OLLAMA_FLASH_ATTENTION=1과 OLLAMA_KV_CACHE_TYPE=q8_0이 설정돼 있었습니다(둘 다 Ollama FAQ에 나오는 설정입니다). Vulkan에서 이 둘을 끄자 입력 처리가 약 2배 빨라졌습니다. 하지만 입력이 길어질수록 속도가 뚝뚝 떨어지는 건 그대로였습니다.
| 입력 길이 (Vulkan, 두 설정 끔) | 입력 처리 속도 |
|---|---|
| 1,195토큰 | 초당 563토큰 |
| 5,070토큰 | 초당 212토큰 |
| 25,754토큰 | 초당 48토큰 (전체 약 9분) |
3단계: ROCm이 왜 안 잡히는지 찾기
Vulkan을 끄고 디버그 로그를 켠 채로 Ollama를 실행하면 GPU를 찾는 과정이 보입니다.
$env:OLLAMA_VULKAN='0'; $env:OLLAMA_DEBUG='1'; $env:AMD_LOG_LEVEL='3'
ollama serve
눈에 띄는 줄이 두 개였습니다.
WARN msg="AMD driver is too old. Update your AMD driver to enable GPU inference."
hipGetDeviceCount: Returned hipErrorNoDevice
첫 줄의 "드라이버가 오래됐다"는 경고를 그대로 믿으면 안 됩니다. 제 드라이버는 2026년 8월 17일자 Adrenalin 26.8.1로 최신이었습니다. 드라이버를 다시 깔아도 해결되지 않았을 겁니다.
그래서 GPU를 찾아 주는 프로그램 파일(HIP 런타임)에 "GPU 몇 개 보여?"라고 직접 물어봤습니다. 파이썬 몇 줄이면 됩니다.
import ctypes, os
dll = r"C:\경로\amdhip64_7.dll"
os.add_dll_directory(os.path.dirname(dll))
h = ctypes.CDLL(dll)
n = ctypes.c_int(-1)
print(h.hipGetDeviceCount(ctypes.byref(n)), n.value) # 0, 1 이면 "GPU 1개 찾음"| HIP 런타임 | 출처 | 찾은 GPU |
|---|---|---|
HIP 6 (amdhip64_6.dll) |
AMD 드라이버가 System32에 설치 | 1개 |
HIP 7.1 (amdhip64_7.dll) |
Ollama 0.34.4에 들어 있는 것 | 0개 |
HIP 7.14 (amdhip64_7.dll) |
llama.cpp b10766 배포판에 들어 있는 것 | 1개 |
드라이버도 그래픽카드도 멀쩡했습니다. Ollama에 같이 들어 있는 HIP 7.1 파일만 GPU를 못 찾고 있었습니다.
4단계: 바꾸기 전에 ROCm이 정말 빠른지 재 보기
llama.cpp는 배포 페이지에 Windows용 ROCm 빌드를 올려 둡니다. 이 빌드의 llama-bench로 Ollama가 이미 받아 둔 모델 파일(%USERPROFILE%\.ollama\models\blobs 안의 GGUF)을 그대로 불러오면 같은 조건에서 비교할 수 있습니다. 이미 1만 6천 토큰이 쌓인 상태에서 1,024토큰을 더 읽는 속도입니다.
| 가속 방식 | Flash Attention | 입력 처리 (16k 누적) | 생성 (16k 누적) |
|---|---|---|---|
| Vulkan | 끔 | 초당 79토큰 | 초당 27.5토큰 |
| Vulkan | 켬 | 초당 63토큰 | 초당 49.3토큰 |
| ROCm | 끔 | 초당 127토큰 | 초당 17.2토큰 |
| ROCm | 켬 | 초당 687토큰 | 초당 50.0토큰 |
긴 입력에서 ROCm + Flash Attention이 Vulkan보다 약 9~11배 빨랐습니다. Flash Attention은 Vulkan에서는 오히려 손해였고 ROCm에서는 효과가 컸습니다. 같은 설정도 가속 방식에 따라 결과가 정반대일 수 있으니 직접 재 보는 게 안전합니다.
5단계: Ollama에 GPU를 찾는 HIP 파일 넣어 주기
공식 해결책이 아니라 우회 방법입니다. 반드시 원본을 백업하세요.
- Ollama를 완전히 종료합니다(작업 표시줄 아이콘 → Quit).
%LOCALAPPDATA%\Programs\Ollama\lib\ollama\rocm_v7_1\폴더의amdhip64_7.dll과amd_comgr*.dll을 백업 폴더에 복사합니다.- llama.cpp
win-rocm-7.14압축 파일에서amdhip64_7.dll,amd_comgr.dll,rocm_kpack.dll을 꺼내rocm_v7_1\에 덮어씁니다. - 사용자 환경변수에
OLLAMA_FLASH_ATTENTION=1을 넣고 Ollama를 다시 켭니다.
"driver is too old" 경고는 계속 찍히지만 GPU는 이렇게 잡힙니다.
msg="inference compute" library=ROCm compute=gfx1030 name=ROCm0 description="AMD Radeon RX 6800 XT"Ollama를 업데이트하면 이 파일이 원래대로 덮입니다. 업데이트 뒤 다시 느려지면 이 로그 줄부터 확인하세요.
결과: 같은 입력을 Ollama로 다시 재기
| 구성 | 2만 5천 토큰 입력 처리 | 전체 시간 | 인사 한 줄 |
|---|---|---|---|
| qwen3 8b, Vulkan | 초당 48토큰 | 약 544초 | — |
| qwen3 8b, ROCm + FA | 초당 796토큰 | 41.5초 (모델 로딩 8초 포함) | 1.6초 |
| qwen3 14b, ROCm + FA, 캐시 f16 | 초당 301토큰 | 109초 | 3.4초 |
| qwen3 14b, ROCm + FA, 캐시 q8_0 | 초당 475토큰 | 69초 | — |
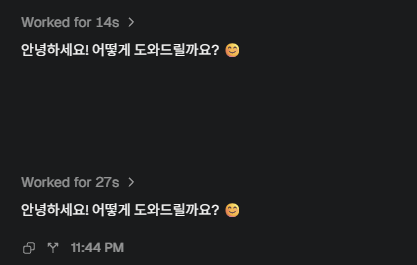
수정 후: 같은 인사에 14초와 27초. 27초 쪽은 14b 모델로 바꾼 직후 첫 메시지라, 약 1만 2천 토큰의 입력을 처음부터 다시 읽어야 했습니다.
덤: 큰 모델이 PC를 힘들게 했던 이유
컨텍스트 40,960토큰에 기본 캐시(f16)로 qwen3 14b를 올리자 그래픽카드 메모리 16GB 중 15.7GB를 썼습니다. 긴 입력 뒤 답변 생성은 초당 4토큰까지 떨어졌습니다. OLLAMA_KV_CACHE_TYPE=q8_0으로 캐시를 절반으로 줄이자 12.6GB로 내려가고 생성 속도도 초당 26.5토큰으로 돌아왔습니다. 큰 모델을 올렸을 때 PC 전체가 버벅이면 모델 탓을 하기 전에 ollama ps로 그래픽카드 메모리가 꽉 찼는지부터 보세요. 꽉 찼다면 캐시나 컨텍스트를 줄이는 게 먼저입니다.
에이전트 앱에서 모델을 바꾼 직후 첫 메시지가 느린 것도 정상입니다. 이전 모델이 만들어 둔 캐시를 새 모델은 쓸 수 없어서 약 1만 2천 토큰을 처음부터 읽습니다. 같은 대화의 다음 메시지는 새로 붙은 1,650토큰만 처리해서 3.5초면 끝났습니다.
점검 목록
- 무언가 바꾸기 전에 응답 시간을 입력 처리와 답변 생성으로 나눠 본다.
- 앱이 메시지마다 실제로 몇 토큰을 보내는지 확인한다. 에이전트 앱은 1~2만 토큰을 보내는 경우가 많다.
- 로그의
inference compute줄에서library=값으로 가속 방식을 확인한다. - "driver is too old" 경고만 믿지 말고 드라이버 버전을 확인하고, HIP 런타임별로 GPU를 찾는지 직접 확인한다.
- Flash Attention은 가속 방식마다 따로 재 본다. 이번에는 ROCm에서 이득, Vulkan에서 손해였다.
- 모델과 캐시가 그래픽카드 메모리 안에 여유 있게 들어가게 한다. 큰 모델이라면 q8_0 캐시가 가장 쉬운 해결책이다.